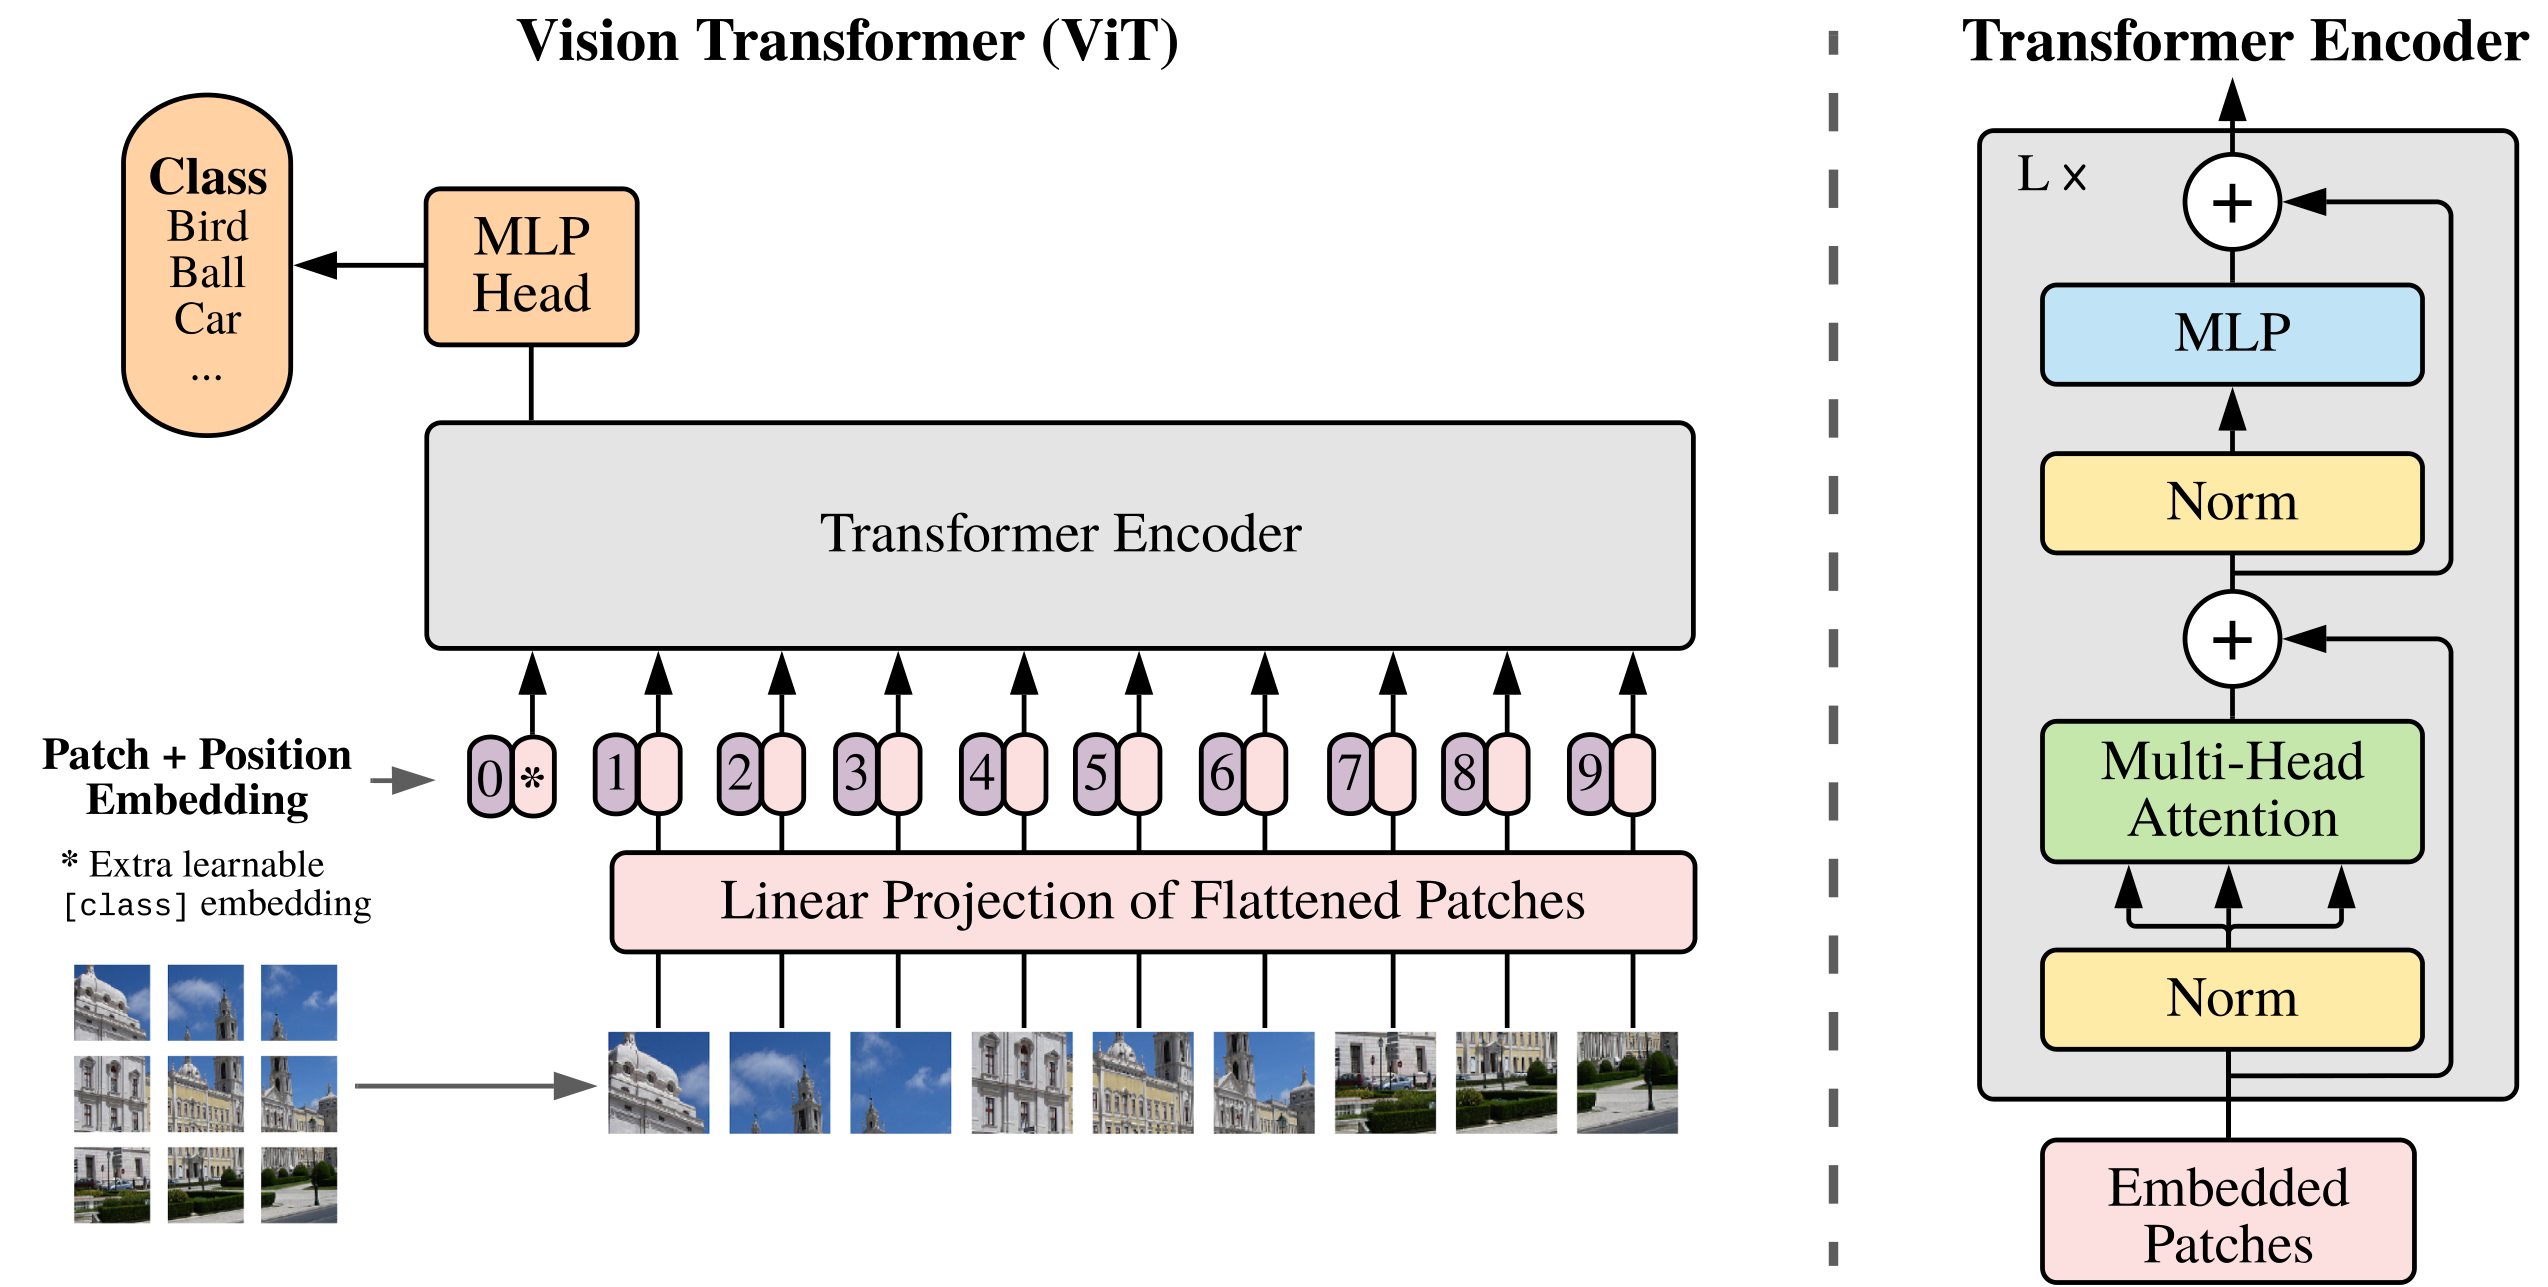
YOLO 是怎么工作的:目标检测的原理与流程 目标检测要同时回答"有什么"和"在哪里",而且答案的数量不固定。YOLO 把这两个问题压成一次前向传播的回归,十年间从七乘七网格走到免 NMS 的端到端,变化的是手段,不变的是实时这个约束 2026-10-20 人工智能 计算机视觉 深度学习 计算机视觉 YOLO 目标检测 向量存储 向量存储不只是"存向量"——它要在一个不能同时满足召回、延迟、内存的三角里做取舍,还要把标量过滤、增删改、权限和一致性一并解决。索引结构决定了前一半,工程能力决定了后一半 2026-10-20 人工智能 RAG 与知识 向量检索 向量数据库 近似最近邻 索引结构 RAG从文档切分到答案引用 检索增强生成要解决的不是"让模型知道更多",而是在一个固定的上下文预算里,从百万级片段中挑出真正该进窗口的那几个——这是一个排序问题,也是一个误差会逐级累积的工程链路 2026-10-20 人工智能 RAG 与知识 RAG 向量检索 混合检索 Transformer 是怎么工作的 2017 年那篇论文真正拿掉的不是注意力,而是循环——把序列上不可并行的依赖换成一次矩阵乘法,让序列上任意两个位置直接相乘,此后所有主干模型都长在这个骨架上 2026-10-15 人工智能 大模型基础 注意力机制 Transformer 位置编码 多模态模型 文本是主模态,其它模态都要先被翻译成它——多模态的全部工程问题都从这句话长出来。文本是一种高效的压缩格式,但不是世界的全部格式 2026-10-14 人工智能 计算机视觉 CLIP 多模态 视觉语言模型 视觉 模型微调与对齐 微调和对齐是两条不同的轴:一个改"会不会做",一个改"愿不愿意做/怎么做"。 2026-10-13 人工智能 训练与对齐 微调 对齐 SFT DPO AI算力设施:算力服务器、数据存储、应用服务器 模型跑在什么上面。三类设施——算力服务器(发动机)、数据存储(油箱加仓库)、应用服务器(方向盘加仪表盘)——按数据流串起来看,各自的选型维度、要算的账和最容易撞的墙。 2026-10-12 人工智能 评测与算力 算力 存储 推理部署 AI 基础设施 后训练模型的产生:基座 SFT 对齐 推理 部署 大模型不是一次训练出来的,而是一条流水线走下来的:先在语言里泡大(基座),再学会说话(SFT)、学会选择(DPO/RLHF)、学会思考(GRPO/RLVR),然后学会省着用(量化/蒸馏)、学会看(多模态)、学会行动(工具使用)。每站讲清机制、数据长什么样、具体数字和会踩的坑。 2026-10-10 人工智能 训练与对齐 论文笔记 大模型 SFT DPO RLHF GRPO AI Agent:一个循环、五个部件,和工程上真正难的地方 agent 不是"更聪明的聊天机器人",而是一个"想—做—看"的循环加上五个部件。这篇按这个骨架把 agent 讲清楚:workflow 和 agent 的界限在哪、模型要多什么能力、工具怎么标准化(MCP)、记忆和规划怎么做、以及工程上真正难的是什么。 2026-10-10 人工智能 大模型基础 AI Agent ReAct MCP 工具调用 论文笔记 高效微调(PEFT):LoRA 家族是怎么把微调成本打下来的 全量微调一个 7B 模型要 120GB 显存,LoRA 只要约 16GB,4bit QLoRA 约 6GB——高效微调省下的不是一点半点。 2026-10-10 人工智能 训练与对齐 论文笔记 大模型 高效微调 PEFT LoRA 世界模型(World Models):它是什么、用来干什么、现在到哪一步 世界模型想让模型学会"如果我这么做,世界接下来会变成什么样"。它是机器人与自动驾驶里最被看重的一块,这篇按四条技术路线梳理它是什么、用在哪,以及现在的真实瓶颈。 2026-10-09 人工智能 论文笔记 世界模型 World Models JEPA 具身智能 递归自我改进(RSI) RSI 已经不只是哲学思辨——2025 年出现了能改写自己代码并在基准上涨分的 agent,2026 年 10 月又集中出现了一批"造自改进环境"的流水线和专门测"进化会不会跑偏"的基准;三篇 2026 下半场的综述进一步把"怎么量"做成了方法论:自主度五级刻度、可信度三视角、评测谱系。 2026-10-09 人工智能 大模型基础 AI Agent RSI 递归自我改进