同一张街景图,分类说”这是街道”,检测说”这里有一个人、两辆车”,分割要回答的是:人的轮廓是哪些像素、每辆车的轮廓是哪些像素。输出从几个数变成几十万个像素的分类结果,这是分割与检测最本质的差别。
一、三种分割任务
分割家族有三个成员,区分它们最直接的方式是看”同一张图各自输出什么”。

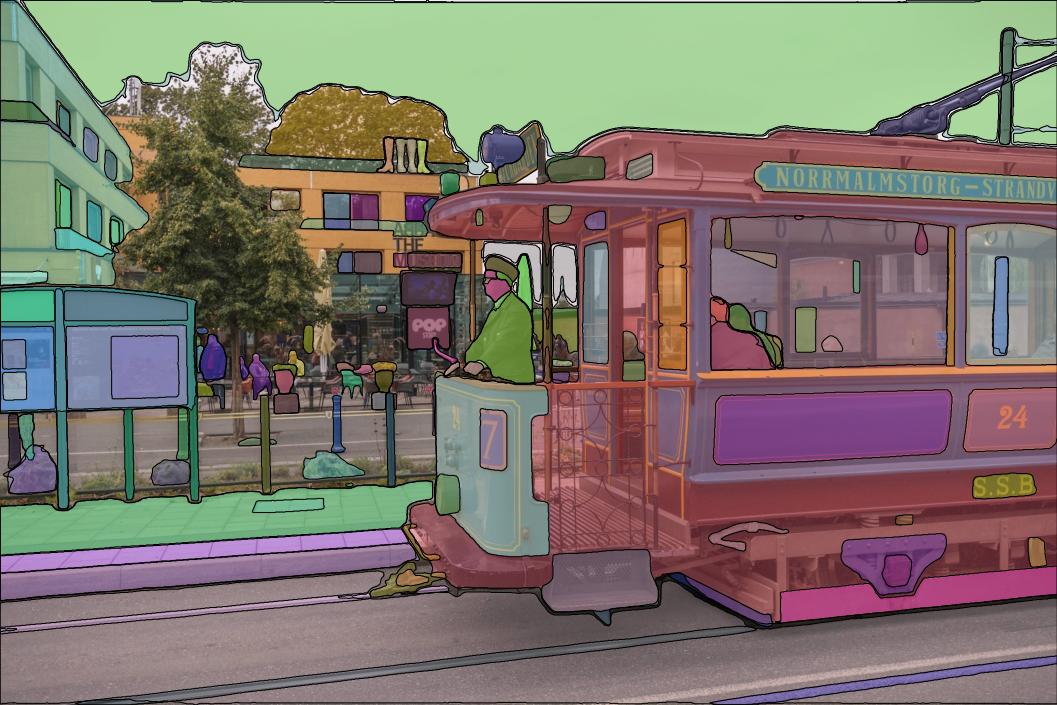
图源:Kirillov 等,Panoptic Segmentation(CVPR 2019),本节四张配图均截自该文示例
语义分割(semantic segmentation):给每个像素一个类别标签,但不区分同类别的不同个体。图里三只羊,全部标成”羊”,在像素层面是同一个标签。

实例分割(instance segmentation):先找出每个目标实例,再给出每个实例的像素级掩码。三只羊是三个独立的掩码,各带类别与置信度。它和检测的关系是直接的:实例分割等于在检测的框之外,把矩形升级成像素轮廓。

全景分割(panoptic segmentation):两者的合体。画面被完整切分——既区分实例(可数的”东西”:行人、车辆),也覆盖无实例的背景(不可数的”stuff”:天空、路面、植被),每个像素都有一个归属,没有”没分到的像素”。

输出形态决定了一切:分类的标注是每图一个标签,检测是每图若干个框,分割是逐像素的轮廓标注——标注成本差一到两个数量级,这也解释了分割领域几个标志性事件(后文的 SAM 数据引擎)为什么都围绕”怎么便宜地造标注”。
二、从分类到逐像素:FCN 与编解码结构
分类网络的输出是”一列类别分数”,它靠全连接层把特征图压成一个向量。2015 年的全卷积网络(FCN,CVPR 2015)做了那个时代最重要的改造:把全连接层全部换成卷积层,让网络输出的是一张”分数图”而不是一个向量——每个空间位置对应一个类别分布,等于对每个像素做分类。输入也不再要求固定尺寸。
但卷积和池化会把分辨率一路降下来,最终输出的分数图比原图小几十倍。把它放大回原图是粗糙的,于是编解码结构成为标配:编码器不断降分辨率提语义,解码器逐步把分辨率还原回来。U-Net(MICCAI 2015)在此之上加了跳跃连接——把编码器浅层的细节特征直接接到解码器对应尺度上,语义来自深层、位置细节来自浅层。这个结构诞生于医学影像,因为那里训练样本少、轮廓精确性要求极高,跳跃连接的”细节直通”恰好补了深层网络丢失的细节。医学影像分割至今仍是 U-Net 家族的天下。
DeepLab 系列走了另一条路:空洞卷积在不下采样、不增加参数的前提下扩大感受野,保住分辨率;配合条件随机场做边界细化。它的多尺度并行的空洞卷积(ASPP)后来也被各家借鉴。
到这一步,语义分割的范式成型:逐像素分类。但实例分割需要的不止这些——同一类的三个个体要分出彼此,”逐像素分类”这个框架天然做不到,因为分类不含”这是第几只”的概念。
三、实例分割的两条实现路线
自上而下:先检测,再分割。既然检测已经能定位每个实例,就在每个实例的区域里再做一次”前景/背景”的像素分类。代表是 Mask R-CNN(ICCV 2017):在 Faster R-CNN 之上加第三条分支,与分类、框回归并行,对每个候选区域输出一个掩码。
它的技术贡献是 RoIAlign。此前的 RoIPool 在把不规则区域映射到固定网格时做了两次取整,特征和原图之间错位可达数个像素——对框回归无所谓,对逐像素的掩码是致命的。RoIAlign 用插值取消取整,特征与像素严格对齐。这个改动让掩码精度提升明显,也成了之后所有”在区域内做像素任务”的标准件。另两个设计:掩码分支对每个类别独立输出一张二值掩码(避免类别间的竞争),掩码损失只用该真实类别那一支算二值交叉熵。

自上而下的质量依赖检测框:框偏了,掩码整体跟着偏。
自下而上:先逐像素分类,再聚合成实例。对每个像素同时预测语义标签和一个”嵌入向量”,同一实例的像素嵌入彼此靠近、不同实例远离,最后按嵌入聚类分组。这种方式不受检测框限制、天然对称,但分组是个不稳定的环节。
实时路线。YOLACT(ICCV 2019)找到了一个聪明的折中:网络只生成 k 个”原型掩码”(整图级的掩码模板)和每个实例的 k 个组合系数,实例掩码就是原型的线性组合——原型可以整批算,系数很轻,于是分割第一次跑到了实时。SOLOv2(NeurIPS 2020)更进一步:直接按”位置 × 类别”输出掩码,卷积核也由网络动态生成。这两条思路延续到了实时检测器身上——今天 YOLO 系的分割版本(模型名带 -seg)用的就是”检测头加轻量掩码分支”的同族设计,在固定类别的实时场景里非常常用。
四、通用架构:一个网络管三种分割
三种分割各自一套结构,直到 mask classification 范式出现。DETR(ECCV 2020)在检测上验证了”一组可学习 query、集合预测、二分匹配”的可行性;Mask2Former(CVPR 2022)把这个范式搬进分割:一组可学习的 query,每个 query 负责一个实例(或一个语义区域),通过掩码注意力逐步聚焦,训练时用二分匹配决定谁对应哪个真实掩码。
它的意义在于统一:语义分割、实例分割、全景分割用同一套架构、同一个损失,只是后处理的读法不同。此前三种任务三个模型库的局面就此结束,此后新一代分割模型基本都长这个样子。
五、分割一切:SAM 与它的生态
2023 年的 Segment Anything(SAM,ICCV 2023)把分割带进了”基础模型”时代,它的两件事都值得细说。
数据引擎。分割的标注太贵,SAM 用三阶段滚雪球:第一阶段模型辅助人工标注,攒下 12 万张图、430 万掩码;第二阶段让人只标模型不确定的部分,扩到 18 万张图、590 万掩码;第三阶段全自动标注,最终产出 SA-1B 数据集——1100 万张图、11 亿个掩码,全部公开。模型和数据互喂的循环,是它区别于以往分割论文的地方。
提示式架构。SAM 的三件套是重量级图像编码器(ViT-H,占算力大头)、轻量的提示编码器(点、框、掩码都可以作为提示)和毫秒级的掩码解码器。这个配比的设计意图:贵的部分对每张图只算一次,便宜的解码器可以反复跑——用户点一下、框一下,掩码立刻更新,交互式修正是设计目标而不是附加功能。同一个提示有歧义时(”这个点”可能指整个物体或物体的一部分),模型输出三个候选掩码让用户选。
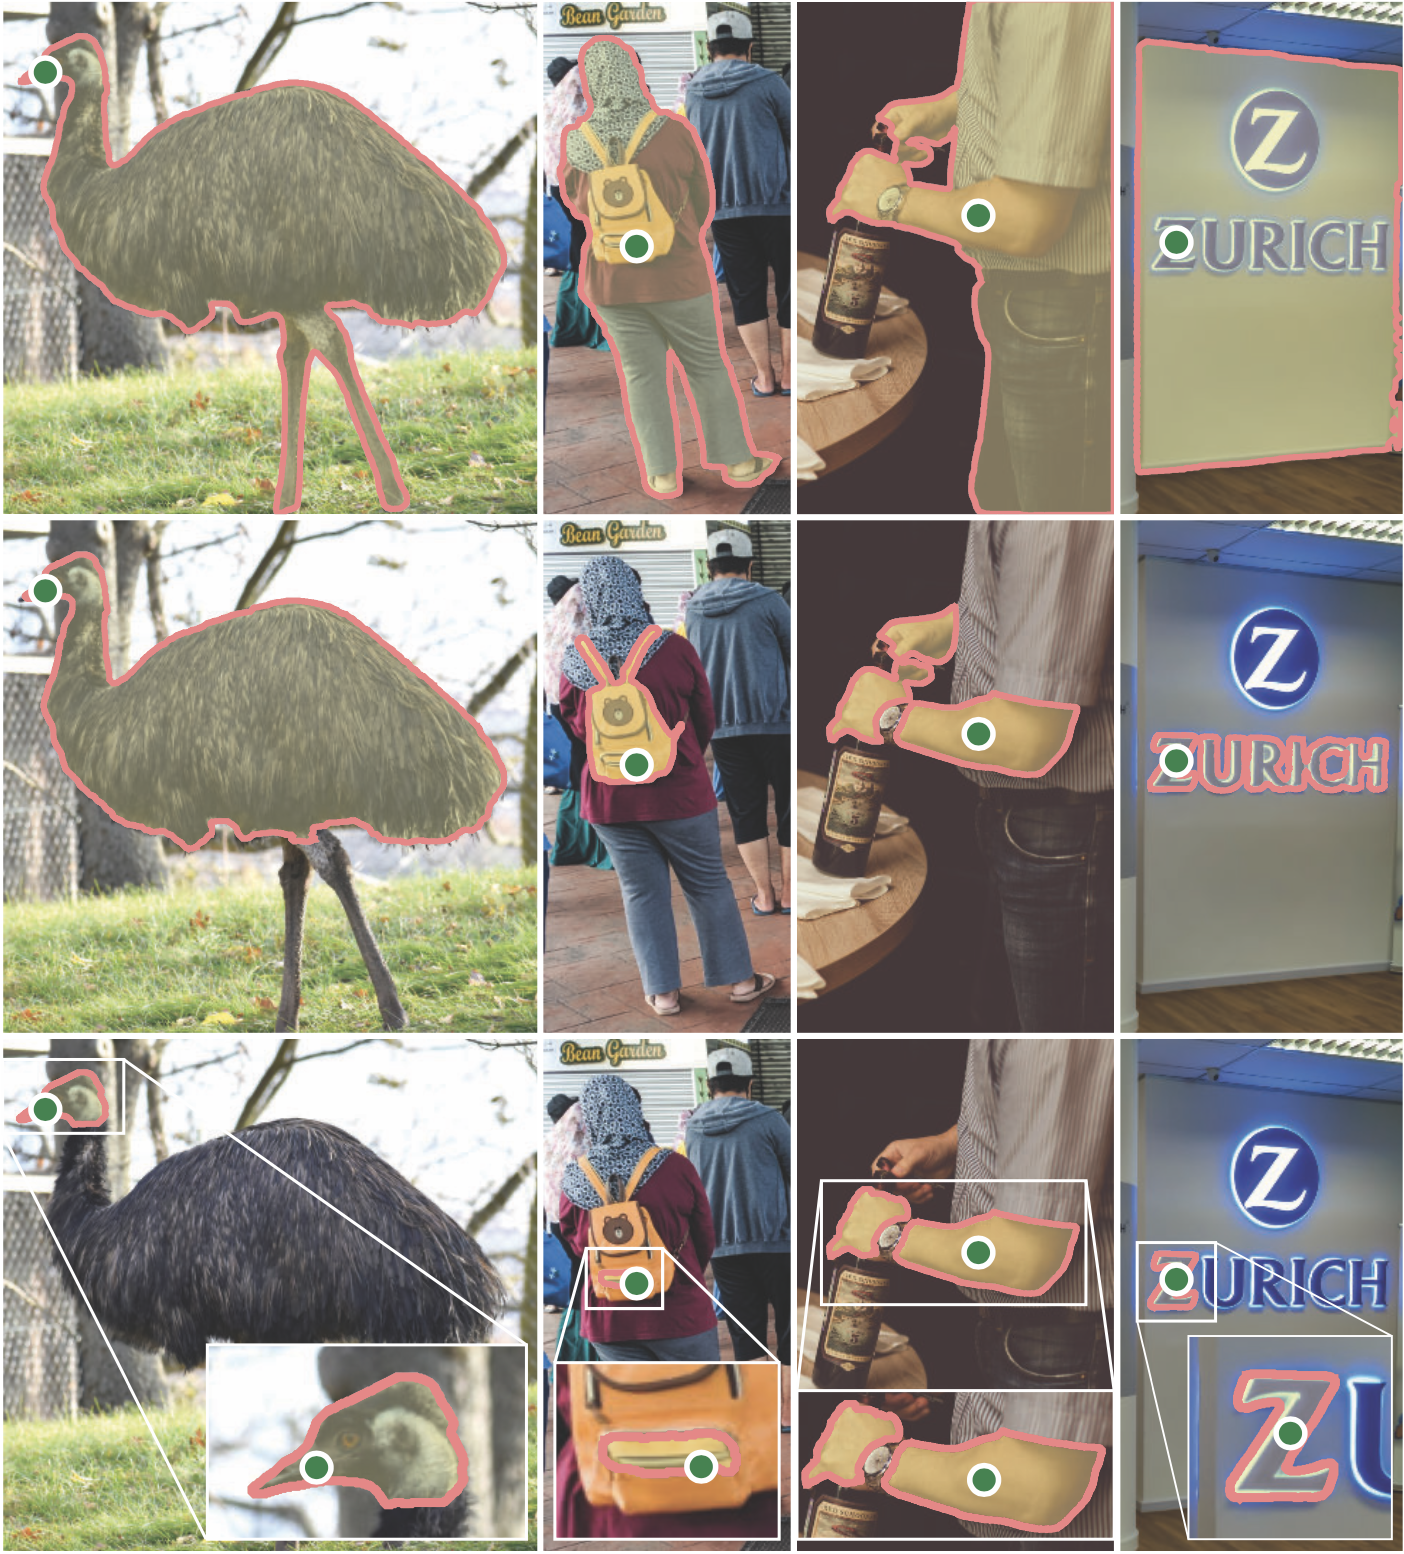
SAM 的零样本能力是跨数据集和域的,但有两个边界要知道:它不输出语义类别——掩码是类别无关的,它说不出这块是”羊”还是”狗”;对细长的凹陷结构、精确边缘的表现也有限。
在这两个边界之上还有一条产线里最先撞上的坑:SAM 按”视觉边界”分割,而业务要的是”语义边界”。它的训练信号是”哪些像素在视觉上属于同一个整体”,不是”哪些像素属于同一个语义概念”。三种典型表现:外观不同的两个目标连在一起,它能切开(视觉边界清晰);外观相同的目标排成一排(一排同款产品、一列相似的车),它可能整排切成一块;一个目标被栏杆之类的细物横穿、纹理断裂,它可能切成两块。处理思路也由此而来:纯视觉线索不够时,要么补位置与业务规则做后处理合并或拆分,要么用文本提示把语义先定位再分割,要么干脆为这个场景微调专用模型。
围绕它的效率线很快出现:MobileSAM(预印本)把图像编码器换成轻量网络,编码降到毫秒级、整体可上移动端;FastSAM(预印本)干脆用实时检测器的分割版本在 SA-1B 子集上重训,速度提升明显、精度有折损。两条路都是”保留提示式用法、把编码器便宜化”。
视频把分割的难度又抬了一级:目标会动、会互相遮挡、会出画再入画。视频分割的典型工作方式是第一帧给一个提示(点、框或掩码),模型把该目标在后续帧里自动传播下去——难的全在传播里:被遮挡后重新出现时要认得出来,几个外观相似的目标交叉穿行时要跟得住,目标自身形态变化(转身、缩放)时要跟得上。
SAM 2(ICLR 2025)就是为这条链路设计的:引入流式记忆模块,把过去帧的高质量特征存进记忆库供当前帧查询,处理跨帧的目标遮挡与重现;标注以掩码形式随帧传递,速度做到实时(论文报告 44 FPS)。图像任务上它同样更强——用约六分之一的图像数据训练,表现超过了 SAM 一代。


配套的 SA-V 视频数据集约 5 万段视频、64 万个掩码标注。
落地选型就在这几个变体里转:全量 SAM 精度最好、编码最重(单张图的编码在百毫秒到秒级,取决于硬件);MobileSAM 把编码压到毫秒级、可上移动端;FastSAM 用实时检测器结构换速度,掩码质量有折损;SAM 2 图像视频通吃,多数新项目可以直接从它起步。共同点是提示式用法不变——选型时先确认交互方式:用户点选修正的交互式场景,哪个变体都合适;全自动批量处理时,编码器成本乘以数据总量,压缩立刻从可选项变成必选项。
六、开放词表分割:给掩码接上语义
这里要把两个常被混在一起的模型分开。CLIP(ICML 2021)是图文对齐模型:它把图像和文本映射到同一个嵌入空间,能判断”这张图和这句话是否匹配”,但它不做像素级输出,也不做分割。“分割一切”是 SAM,是 Meta 的提示式分割模型,与 CLIP 是两家不同公司的两条工作。
不过 CLIP 的思想确实长出了分割分支。CLIPseg(CVPR 2022)把文本编码成嵌入,与图像每个位置的像素特征算相似度,得到”这个像素与这段文字的匹配程度”——于是分割的类别不再是固定的 N 类,而是任意一句描述。这类开放词表分割解决了 SAM 的另一半问题:SAM 给得出掩码、说不出语义,文本给得出语义、(CLIPseg 一类)像素质量一般。
两条腿拼起来就是目前最常用的组合:Grounding DINO(ECCV 2024)按文本定位出框,SAM 沿框生成掩码。文本给了类别语义,SAM 给了像素质量,这个组合已成为开放词表分割的事实标准,也是大量”自动标注”工具的内核。
七、评估指标:三个任务三套尺子
语义分割用 mIoU。对每个像素算预测与真值的交并比,按类别聚合:
$$\text{IoU} = \frac{\text{TP}}{\text{TP} + \text{FP} + \text{FN}}$$
对每个类别算一个 IoU 再平均就是 mIoU。它对类别不平衡敏感——小类一个像素的错漏在大类面前几乎不可见,所以报告时通常连每类的 IoU 一起看。整体像素准确率(accuracy)在分割里几乎没有参考价值:背景占绝对多数时它天然很高。
实例分割用 mask AP。与检测的 AP 完全同构,只把匹配标准从框的 IoU 换成掩码的 IoU,同样是 0.5 到 0.95 十档取平均,同样按类别与尺寸拆分报告。掩码 AP 天然比框 AP 低——掩码的匹配严格得多。
全景分割用 PQ(panoptic quality)。它把匹配上的区域的平均 IoU(分割质量)乘上匹配的覆盖比例(识别质量):
$$\text{PQ} = \underbrace{\frac{\sum_{(p,g) \in \text{匹配}} \text{IoU}(p, g)}{|\text{匹配}|}}_{\text{分割质量}} \times \underbrace{\frac{|\text{匹配}|}{|\text{匹配}| + 0.5|\text{FP}| + 0.5|\text{FN}|}}_{\text{识别质量}}$$
一个指标同时惩罚分割不准和识别错误。
标注成本也顺着三套尺子看:语义分割要逐像素涂,实例分割逐实例涂,SAM 类模型带来的改变是”点几个点出一个掩码、人工只做修正”——成本降了一个量级,但固定类别的生产任务里,高质量的逐实例标注仍然是绕不开的投入。
八、应用与落地
医学影像是分割最成熟的应用域:器官轮廓、病灶边界都需要像素级输出。U-Net 从这里起家,小数据、高精度要求、边界敏感的域特征与它的结构特点高度匹配。落地时域偏移(不同医院、不同设备)是主要难点。
自动驾驶需要全景分割:可行驶区域是 stuff,车辆行人是 thing,BEV 感知管线里分割是常见组件。
抠图与图像编辑是 SAM 最直接的大众应用:点一下得到掩码,接生成模型做局部重绘,或做商品图处理。SAM 在这条链路里更像”交互式工具”而不是”自动系统”。
自动标注是 SAM 改变行业的方式:Grounding DINO 加 SAM 的组合给数据集做初标,人工只做修正——数据飞轮转起来的速度比纯人工快一个量级。前面 YOLO 实战里”标注质量封死模型上限”的问题,在这条链路里被显著缓解。
自动标注的飞轮是 SAM 们改变行业的方式,值得单独写成一个流程:用 Grounding DINO 加 SAM 的组合给新数据做初标,人工只做掩码修正;修正后的数据训一个轻量的专用模型(实时检测器的分割版本一类);模型成熟后替代组合模型上产线,SAM 们退到处理新类别、新场景的位置。基础模型负责广度,专用模型负责速度与成本,各司其职。
选型的判断顺序:业务只需要”有/没有目标”和位置,检测就够;需要像素归属(抠图、测量、区域统计)才上分割;类别固定且实时,用检测器的分割版本;类别开放或需要交互式,用 SAM 系或文本提示组合;三种分割都要,Mask2Former 一线的通用架构。
九、工程实践:从标注到上线
标注与数据格式
分割标注的两种主流格式各有位置。COCO 格式是 JSON:一个图像列表、一个标注列表、一个类别表,每个标注的多边形是顶点坐标的列表:
{
  "images":    [{"id": 1, "file_name": "a.jpg", "width": 640, "height": 480}],
  "annotations": [{"id": 1, "image_id": 1, "category_id": 1,
                   "segmentation": [[312.1, 96.4, 358.7, 99.2, 355.0, 180.5]],
                   "bbox": [312, 96, 47, 85], "area": 2380}],
  "categories": [{"id": 1, "name": "helmet"}]
}
实时检测器的分割版本(YOLO 系的 -seg)用更简单的文本格式,每行一个实例,类别 id 后跟归一化的多边形顶点:
0 0.49 0.20 0.56 0.20 0.55 0.38 0.49 0.37
存储上还有一层选择:多边形适合人看与前端渲染,RLE(行程长度编码)适合存储——一个不规则的掩码用 RLE 往往只有多边形 JSON 的几分之一,COCO 官方工具链(pycocotools)的编解码就是围绕 RLE 设计的。数据量大时这个差别会直接体现在磁盘与加载速度上。
用 ultralytics 训练自己的分割模型
目录结构与检测完全一致(images 与 labels 对应、txt 同名),只是标注内容从四个数变成多边形顶点。data.yaml 的写法也一样,训练命令把任务换成 segment:
yolo segment train model=yolov8n-seg.pt data=/absolute/path/to/myseg.yaml epochs=150 imgsz=640
yolo segment val   model=runs/segment/train/weights/best.pt
yolo segment predict model=runs/segment/train/weights/best.pt source=test.jpg
预测结果里除框与类别外,每个实例多一个掩码掩膜,可以直接做面积统计、区域抠图、上下游业务判断。
数据增强上实例分割有个专属技巧:copy-paste——把一个实例连同它的掩码从图上抠下来,贴到另一张图里并同步搬标注,稀有类别的样本量由此直接扩充(CVPR 2021 的 Simple Copy-Paste 工作把它做成了标准方法,配合大规模数据能带来显著增益)。它也解释了分割增强的一条铁律:所有几何变换必须同时作用于图像与掩码坐标——图翻转了掩码不翻、图缩放了多边形不缩,标注立刻全错。
SAM 的三种工程用法
自动全图分割:不给提示,在图上按网格撒点,把能分出来的掩码全部输出。适合”不知道图里有什么、先把所有东西分出来”的场景:
from segment_anything import sam_model_registry, SamAutomaticMaskGenerator

sam = sam_model_registry["vit_h"](checkpoint="sam_vit_h.pth")
generator = SamAutomaticMaskGenerator(
    sam,
    points_per_side=32,        # 撒点密度,越大越全、越慢
    pred_iou_thresh=0.88,      # 按预测 IoU 过滤低质量掩码
    stability_score_thresh=0.95)
masks = generator.generate(image_rgb)   # 每个元素含 segmentation、bbox、area、predicted_iou
注意输出的掩码没有类别、没有语义,只有”这里有一块东西”。
交互式提示:重的图像编码只做一次,之后每次点选只跑轻量解码器——这是 SAM 交互体验的工程基础:
from segment_anything import SamPredictor
import numpy as np

predictor = SamPredictor(sam)
predictor.set_image(image_rgb)                    # 重:编码一次
masks, scores, _ = predictor.predict(             # 轻:可反复调用
    point_coords=np.array([[500, 375]]),
    point_labels=np.array([1]),                   # 1 是前景点,0 是背景点
    multimask_output=True)                        # 提示有歧义时返回三个候选
文本组合(Grounded-SAM 模式):文本定位模型出框,SAM 沿框出掩码,类别语义来自文本:
boxes, phrases = grounding_dino.predict(image_rgb, text="helmet . head .")  # 类别以句点分隔
predictor.set_image(image_rgb)
masks, scores, _ = predictor.predict(box=boxes[0], multimask_output=False)
三种用法的选型:批处理走自动分割加过滤;有用户在环走交互式;类别固定但掩码质量要求高,走文本组合或直接训专用模型。
掩码的后处理与一个完整链路
原始掩码通常要过一遍后处理再用:形态学开闭去掉毛刺与孔洞、按连通域面积过滤小噪声、边缘做一至两像素的平滑。这一步代码量很小,对观感的提升立竿见影。
后处理之前还要知道拿到手的掩码是什么分辨率。SAM 一类模型输出的掩码是低分辨率 logits 上采样来的(内部 256 级别再放大到输入尺度),不是原图分辨率——边缘的精度被这个上限框死。做面积统计、尺寸测量这类应用时,边缘几个像素的差异不能当真;需要精确边界时,要么上更高分辨率的专用模型,要么把任务交给 matting 一线(那是一个以边缘为评估核心的独立任务)。
一个完整的产线例子是产品计数加缺陷区域定位:相机采集 → 轻量分割模型(用上文飞轮流程训好)出掩码 → 按连通域计数得到产品数 → 掩码区域的纹理特征交给下游判断缺陷 → 结果图叠加掩码返回。这条链路里分割模型只负责”把区域分出来”,面积、形状、纹理的判断都是普通代码——分割解决像素归属,业务逻辑用常规编程解决,两层分工清楚,系统才好维护。
SAM 类模型的产线角色则是前端的自动标注与新品类的冷启动:新产线、新缺陷类型出现时,组合模型先把初标做完,人工修正后转成专用模型的训练数据。全量 SAM 的权重有 2.4 GB 上下、单图编码在数百毫秒量级,常驻产线不划算,但它做初标的速度远超人工。
十、常见误解
“CLIP 能分割一切。” 分割一切是 SAM。CLIP 是图文对齐模型,输出的是”图与文本的匹配程度”,没有像素级输出;它的思想延伸出了 CLIPseg 一类文本提示分割,但那是另一个模型。
“SAM 知道它分割的是什么。” SAM 是类别无关的:给点给框就出掩码,但掩码没有语义标签。要类别,要么配文本定位模型,要么自己训。
“实例分割就是更细的语义分割。” 两者目标不同:语义分割不分个体,实例分割不分背景。把两者合起来的是全景分割。
“掩码 AP 高,抠图效果就好。” mask AP 对边缘一两像素的差异不敏感(十档 IoU 平均会稀释它),人眼对边缘极其敏感。像素级的发丝级抠图是另一个任务(matting),有自己的评估体系。
“SAM 2 只是加了视频。” SAM 2 的流式记忆让它用更少的图像数据在图像任务上也超过了 SAM 一代,图像场景同样值得换。
“基础模型让标注失业了。” 固定类别的生产任务仍需要精确的逐实例标注和领域微调;SAM 们降低的是标注成本,不是对标注质量的要求。自动标注的正确用法是”机器初标、人工把关”,而不是直接信任。
参考
- 1411.4038 — Fully Convolutional Networks for Semantic Segmentation(FCN)— CVPR 2015(CCF-A)
- 1505.04597 — U-Net: Convolutional Networks for Biomedical Image Segmentation — MICCAI 2015
- 1703.06870 — Mask R-CNN — ICCV 2017(CCF-A)
- 1904.02689 — YOLACT: Real-time Instance Segmentation — ICCV 2019(CCF-A)
- 2003.10152 — SOLOv2: Dynamic and Fast Instance Segmentation — NeurIPS 2020(CCF-A)
- 2005.12872 — End-to-End Object Detection with Transformers(DETR)— ECCV 2020
- 2112.01527 — Masked-attention Mask Transformer for Universal Image Segmentation(Mask2Former)— CVPR 2022(CCF-A)
- 1801.00868 — Panoptic Segmentation(全景分割任务定义与 PQ 指标)— CVPR 2019(CCF-A)
- 1901.02446 — Panoptic Feature Pyramid Networks — CVPR 2019(CCF-A)
- 2012.07177 — Simple Copy-Paste is a Strong Data Augmentation Method for Instance Segmentation — CVPR 2021 Oral(CCF-A)
- 2304.02643 — Segment Anything(SAM)— ICCV 2023(CCF-A)
- 2408.00714 — SAM 2: Segment Anything in Images and Videos — ICLR 2025
- 2306.12156 — Fast Segment Anything(FastSAM)— 预印本 2023
- 2306.14289 — MobileSAM: Efficient Segment Anything — 预印本 2023
- 2010.11929 — An Image is Worth 16x16 Words: Transformers for Image Recognition at Scale(ViT,SAM 图像编码器的基础)— ICLR 2021
- 2103.00020 — Learning Transferable Visual Models From Natural Language Supervision(CLIP)— ICML 2021(CCF-A)
- 2112.10003 — Image Segmentation Using Text and Image Prompts(CLIPseg)— CVPR 2022(CCF-A)
- 2303.05499 — Grounding DINO: Marrying DINO with Grounded Pre-Training for Open-Set Object Detection — ECCV 2024